
Extractor de URL de sitemaps XML gratis
Convierta sitemaps XML en listas de URL limpias al instante. Extraiga enlaces para verificar la indexación masiva y auditorías SEO técnicas. Compatible con exportación TXT, CSV y PDF.
Convierta código desordenado en datos accionables
https://site.com/page1
https://site.com/page2
https://site.com/about
https://site.com/contact
...
¿Qué es un extractor de URL de sitemaps?
Un extractor de URL de sitemaps es una herramienta SEO especializada que analiza archivos de sitemap XML y obtiene una lista limpia en texto plano de todas las URL que contiene.
A diferencia de ver el XML en bruto, repleto de metadatos como las etiquetas <lastmod> y <priority>, el extractor elimina el código y le deja una lista de enlaces.
Si es nuevo en los sitemaps, la documentación oficial de Google es el mejor punto de partida:
Descripción general de sitemaps (Google Search Central).
Esta herramienta es esencial para profesionales SEO que necesitan auditorías masivas, comprobar el estado de indexación o verificar migraciones sin copiar cientos de enlaces a mano. El análisis a veces falla por cortafuegos, redirecciones, XML no válido o errores de servidor. Consulte la tabla, que enumera las causas principales de los problemas de análisis y cómo resolverlos. Para referencias oficiales adicionales, vea el protocolo XML de sitemaps (sitemaps.org) y la página de ayuda de sitemaps de Google Search Console.
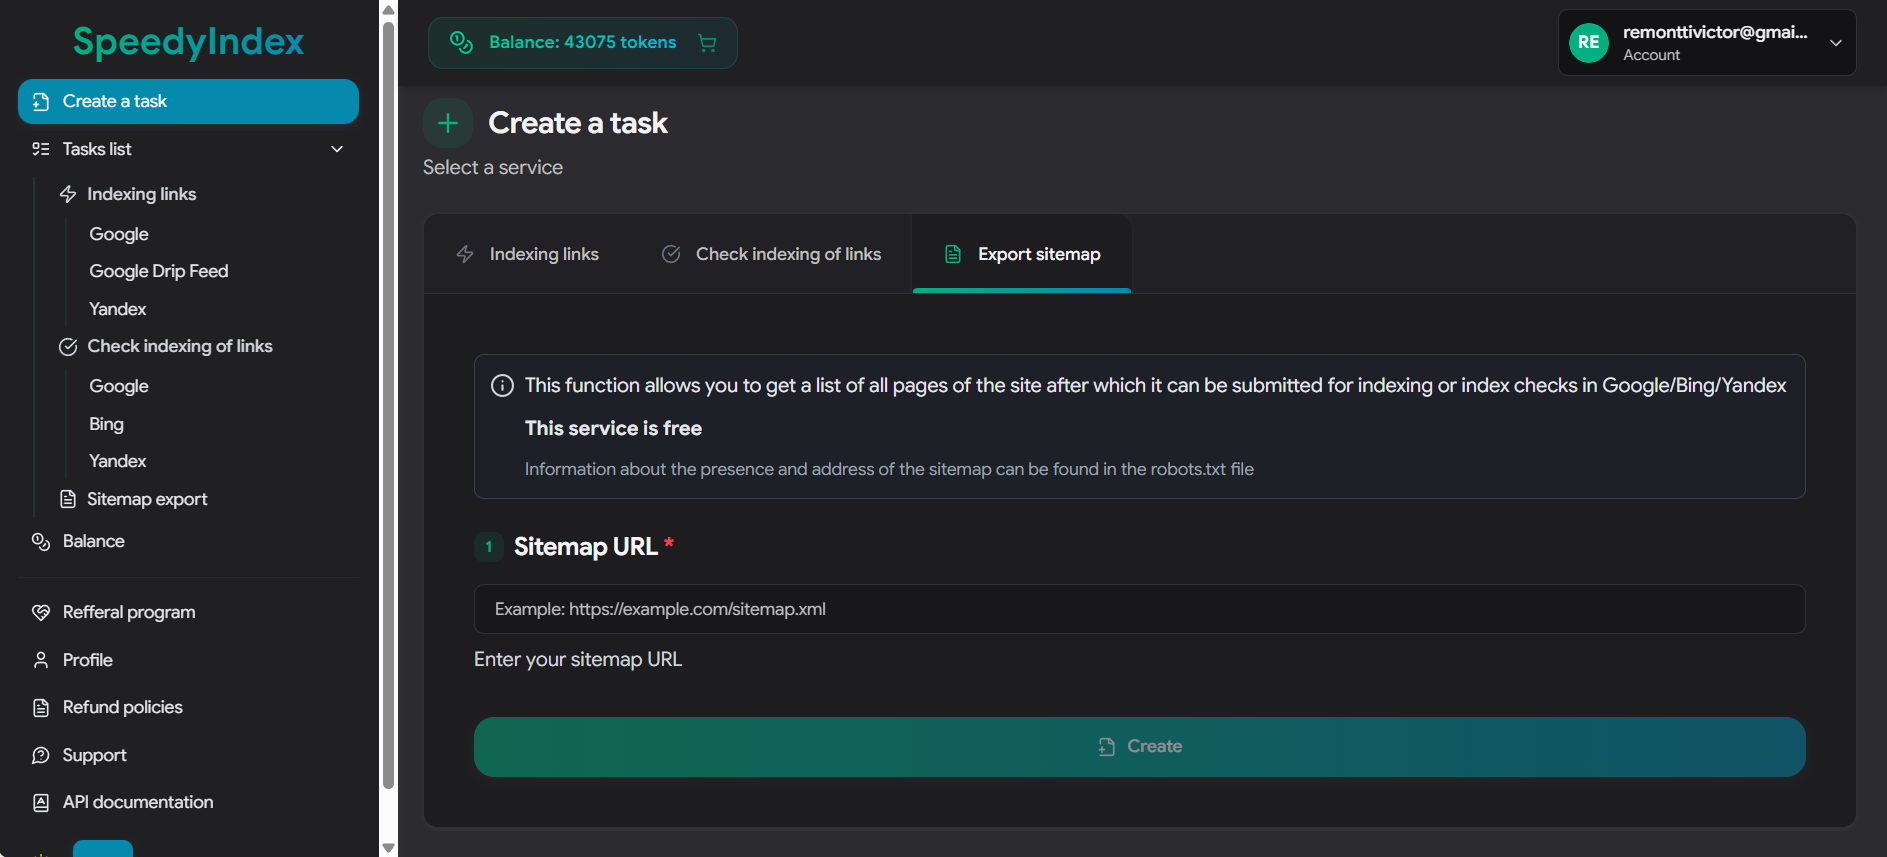
Introduzca el enlace a su sitemap XML (p. ej., https://site.com/sitemap.xml).
Vea la exportación de sitemaps en acción
Vea este breve tutorial para comprobar lo fácil que es extraer todas las URL de su sitemap XML para indexación o comprobación masiva.
⚡ ¿Por qué hacerlo a mano? Automatícelo en el panel.
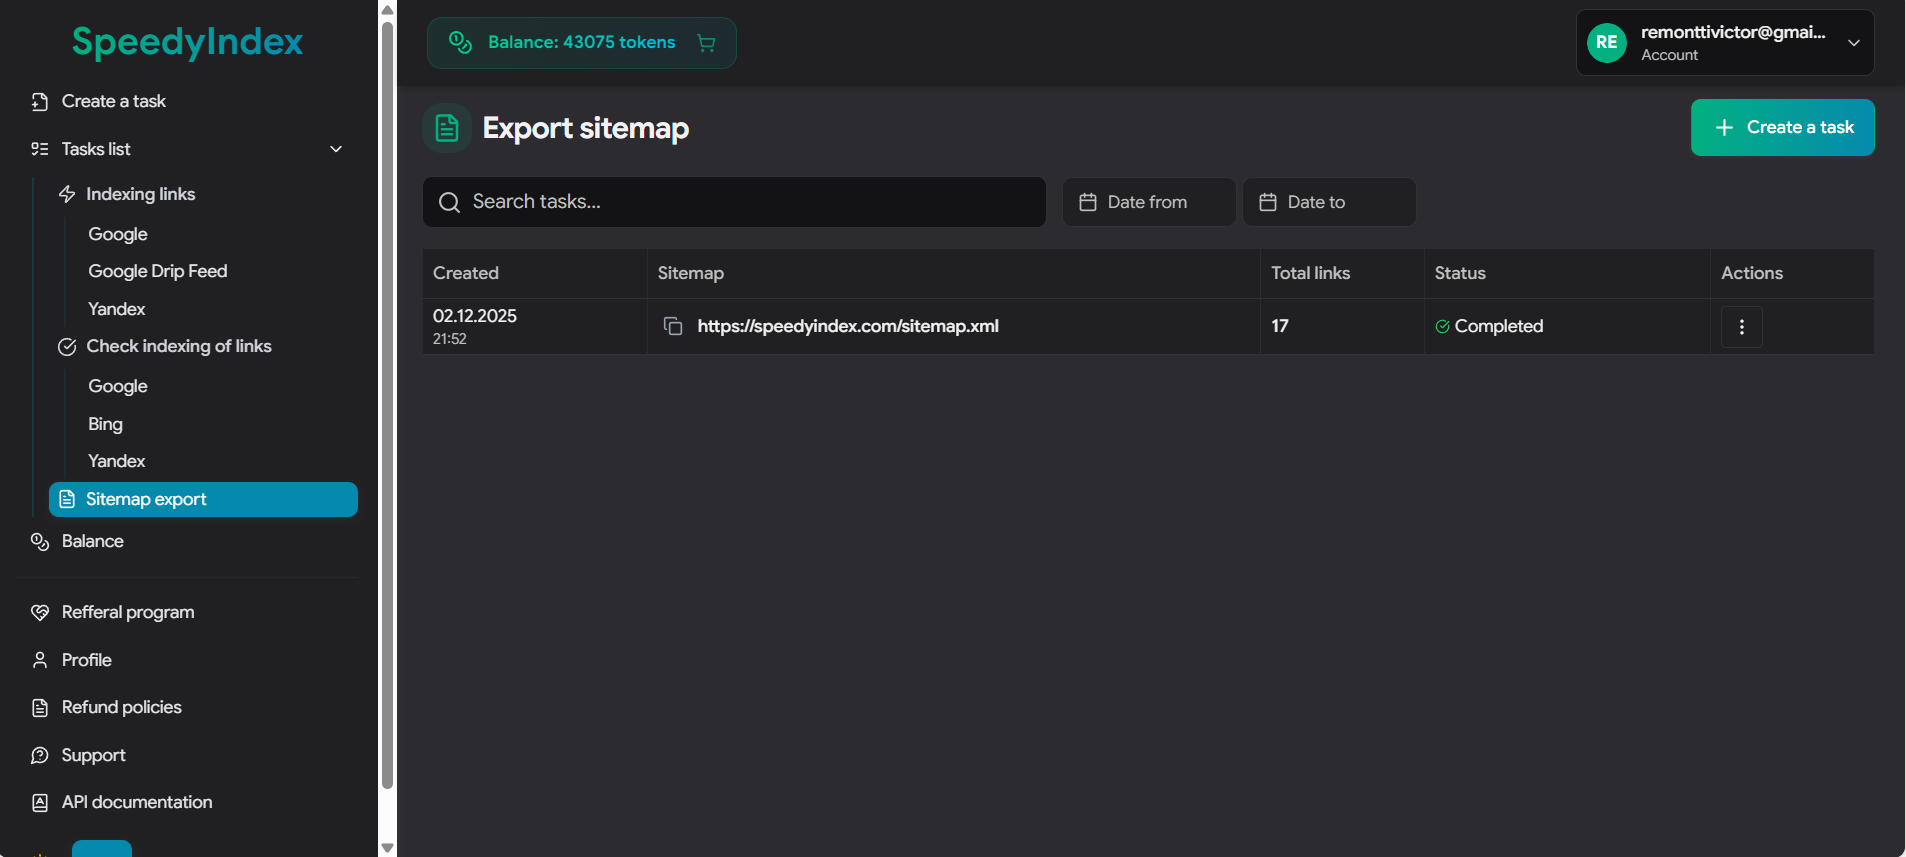
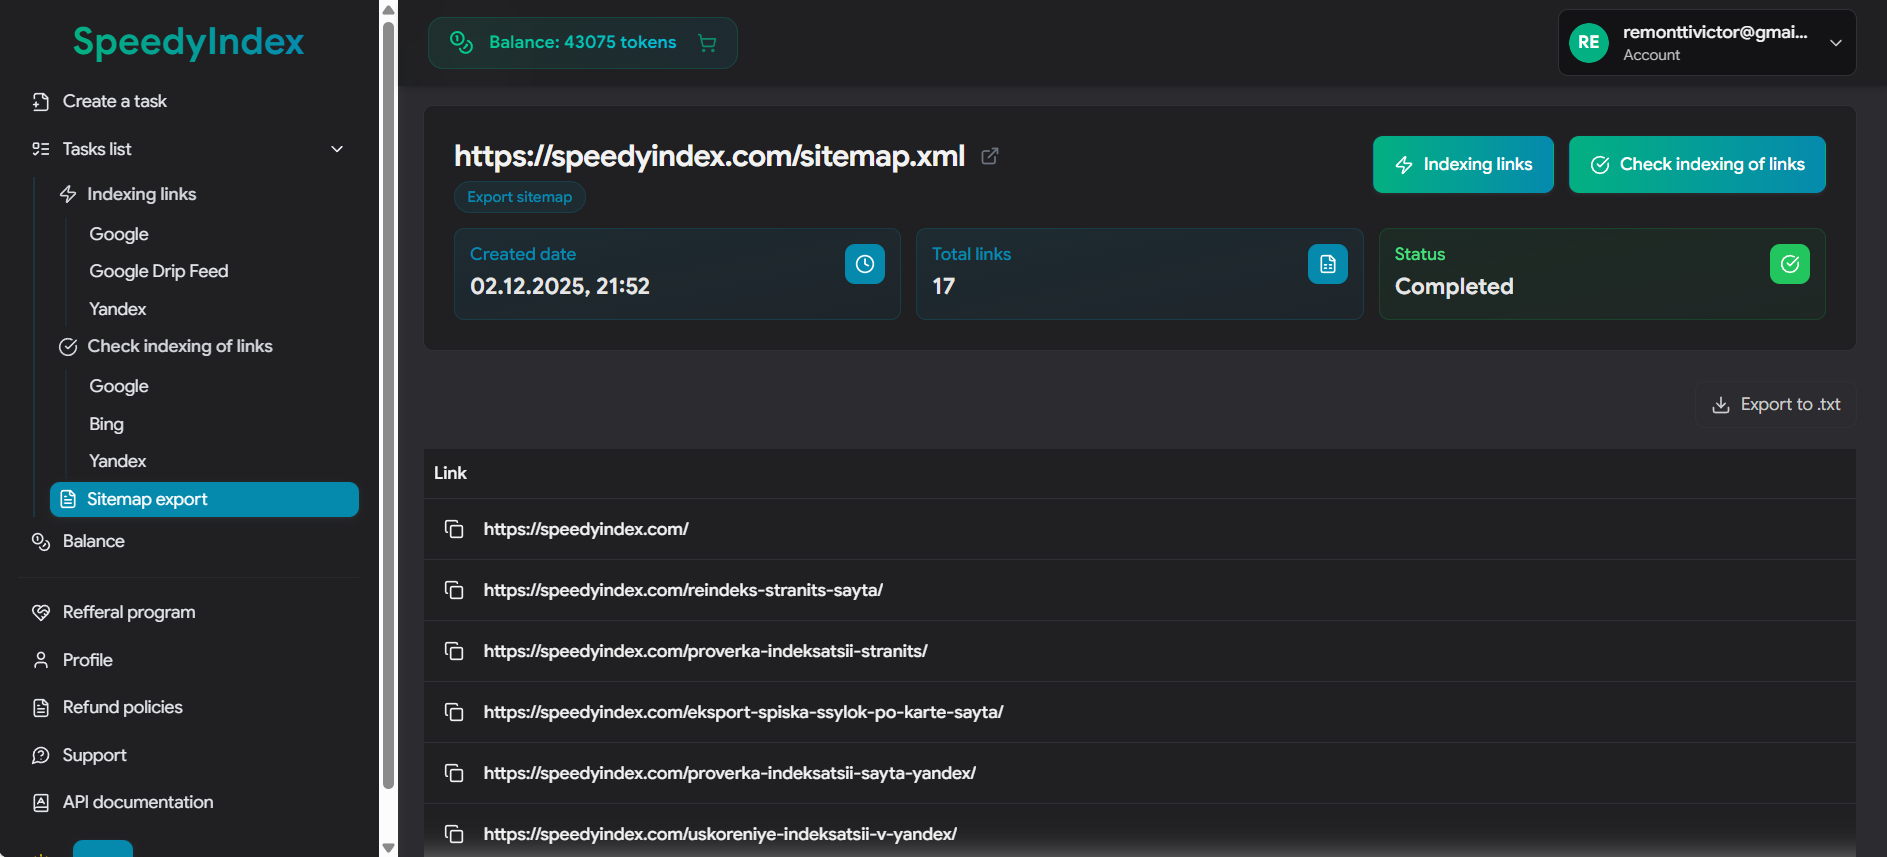
La herramienta de esta página le da un archivo de texto. Vale para tareas pequeñas. Pero en la aplicación web de SpeedyIndex obtiene un flujo completo sin el ir y venir de copiar y pegar:
- ✅ Extraer y analizar: importe sitemaps directamente a su proyecto.
- 🔍 Comprobación instantánea: seleccione los enlaces extraídos y ejecute al instante una comprobación masiva de índice (Google, Bing o Yandex).
- 🚀 Indexación en un clic: ¿ha encontrado páginas no indexadas? Envíelas al servicio de indexación de inmediato.
Flujos de auditoría tras la extracción
Cuando tenga la lista de URL extraída, continúe con estas auditorías técnicas para garantizar la salud del sitio.
1. Verificar el estado de indexación
Asegúrese de que las URL enviadas las sirvan realmente los motores de búsqueda. Las URL del sitemap no indexadas indican bloqueos de calidad o técnicos.
Comprobar índice Google →2. Auditar códigos de respuesta
Revise la lista en busca de enlaces rotos (404) o errores de servidor (5xx) que desperdician presupuesto de rastreo.
3. Validar la migración
Compare la lista extraída con la estructura del sitio nuevo para confirmar que las redirecciones 301 funcionan correctamente.
Checklist de migración →Lista completa de patrones de URL de sitemaps
Si el /sitemap.xml estándar devuelve un error 404, los webmasters suelen usar nombres alternativos según el CMS o la configuración del servidor. Use esta tabla de referencia para localizar el archivo de forma manual.
| Patrón de URL | Plataforma / caso de uso |
|---|---|
/sitemap.xml |
El estándar. Usado por Shopify, Wix, Squarespace, Webflow, Ghost y la mayoría de sitios HTML estáticos. |
/sitemap_index.xml |
WordPress (plugins). El predeterminado de Yoast SEO, RankMath y All in One SEO. También se usa en sitios grandes que dividen los datos en varios archivos. |
/wp-sitemap.xml |
WordPress (nativo). Usado por WordPress 5.5+ si no hay un plugin SEO de terceros instalado. |
/sitemap.php |
Sitios PHP dinámicos. Habitual en foros a medida (vBulletin, XenForo) o scripts PHP que generan XML al vuelo. |
/sitemap.txt |
Texto plano. Usado por sistemas antiguos o sitios estáticos simples (estilo Yahoo!). Contiene una URL por línea. |
/1_index_sitemap.xml |
PrestaShop. A menudo lleva un prefijo numérico con el ID de tienda o de idioma (p. ej., 2_index_sitemap.xml). |
/sitemap.xml.gz |
Comprimido. Usado por sitios de alto volumen (p. ej., portales de noticias) para ahorrar ancho de banda. Debe descomprimirse antes de analizarlo. |
/feeds/posts/default?orderby=updated |
Blogger (Blogspot). El feed Atom predeterminado usado como sitemap para Google. |
/sitemap/sitemap.xml |
Frameworks. Estructura habitual en Django, Laravel o sitios que organizan los recursos en subcarpetas. |
/news-sitemap.xml |
Google News. Archivo específico para editores, con artículos publicados en las últimas 48 horas. |
/image-sitemap.xml |
SEO de imágenes. Archivo dedicado a enlaces de CDN y recursos multimedia (habitual en portfolios de fotografía). |
Si nada de lo anterior funciona, revise el archivo
/robots.txt (p. ej., example.com/robots.txt). Los webmasters deben declarar ahí la ubicación del sitemap con la directiva: Sitemap: https://example.com/custom-name.xml.
Por qué no se descarga ni se analiza su sitemap.xml: checklist de solución de problemas
Si la herramienta no puede obtener su sitemap (Obtener desde URL) o recibe una lista de URL vacía, la causa suele ser una de estas: bloqueo antibot (Cloudflare/WAF), formato incorrecto (gzip/HTML en lugar de XML), errores de sintaxis XML, redirecciones y códigos HTTP incorrectos (3xx/4xx/5xx), problemas SSL/TLS, problemas de codificación o una estructura de sitemap no estándar. A continuación, una checklist detallada que responde: «¿Por qué no puedo descargar o analizar mi sitemap?»
| Tipo de problema | Por qué falla (síntoma) | Qué hacer (solución) |
|---|---|---|
| Sitemap comprimido (.gz) |
La URL devuelve un archivo .gz (binario). El navegador puede mostrarlo, pero la obtención o copia automática suele devolver el formato incorrecto.
|
Descárguelo y descomprímalo en local (7‑Zip, etc.). Después use la pestaña «Pegar código XML» o pegue el XML descomprimido. |
| Cloudflare / WAF / antibot (403 Forbidden) | El servidor bloquea las solicitudes automáticas (cURL/fetch): 403, CAPTCHA, desafío JS, Bot Fight Mode, reglas ModSecurity/WAF. A veces se abre en el navegador, pero la herramienta no puede obtenerlo. |
Abra el sitemap en el navegador, pulse Ctrl+U (Ver código fuente), copie el XML en bruto y péguelo en la pestaña «Pegar código XML».
Compruebe también si el WAF bloquea por User‑Agent, país o ASN.
|
| Se devuelve HTML en lugar de XML (página de error/inicio de sesión) |
La URL del sitemap en realidad devuelve HTML: una página 404, un muro de inicio de sesión, «Access denied», una página antibot o una página de error personalizada.
El analizador no encuentra etiquetas <loc>.
|
Abra la URL y revise «Ver código fuente». Un sitemap real debe ser XML con <urlset>/<sitemapindex> y <loc>.
Si es HTML, corrija la URL del sitemap o las reglas de acceso del servidor.
|
| Redirecciones (301/302/307/308), cadenas o bucles | La URL del sitemap pasa por varias redirecciones o se queda en un bucle. La URL final puede acabar en 403/404 o redirigir a otro dominio, protocolo o versión. |
Asegúrese de que la URL final devuelva 200 OK y XML. Acorte las cadenas de redirección y use la URL canónica del sitemap
(normalmente HTTPS + la versión WWW o no WWW preferida).
|
| Problemas SSL/TLS (certificado, SNI, cifrados obsoletos) | HTTPS está activo, pero el certificado está caducado o no es válido, la cadena está rota, el SNI está mal configurado o TLS está desactualizado. El navegador puede cargarlo, mientras que los clientes automáticos fallan el handshake. | Corrija el certificado SSL y la configuración TLS (cadena completa, protocolos modernos). Confirme que el sitemap carga por HTTPS sin avisos. |
| Errores de servidor (5xx), timeouts, hosting inestable | El servidor devuelve 500/502/503/504, expira o responde demasiado lento al descargar el sitemap. | Revise registros y límites del servidor (PHP/CPU/RAM), ajustes de CDN/origen y el tamaño de la respuesta. Añada caché, aumente recursos o divida el sitemap en archivos más pequeños. |
| Restricciones de acceso (401/403), Basic Auth, sitio de pruebas | El sitemap exige inicio de sesión (Basic Auth/tokens) o está bloqueado por reglas de IP/geo. La herramienta recibe 401/403. | Haga el sitemap legible de forma pública (al menos para los bots de búsqueda). En staging, elimine el sitemap o protéjalo de forma deliberada. |
| Formato incorrecto: RSS/Atom/JSON en lugar de sitemap XML |
La URL parece un sitemap, pero en realidad es un feed o una respuesta de API. No sigue el protocolo de sitemaps y puede no contener <loc>.
|
Encuentre el sitemap real: revise /robots.txt en busca de una línea Sitemap: y pruebe rutas habituales
(/sitemap.xml, /sitemap_index.xml, /wp-sitemap.xml).
|
| XML no válido (errores de sintaxis) |
Etiquetas sin cerrar, espacios de nombres rotos, caracteres sin escapar (como & en lugar de &)
o texto extra antes del primer <.
|
Valide el XML (por ejemplo, con un validador XML del W3C), corrija la sintaxis e inténtelo de nuevo. Si hay basura antes de que empiece el XML, elimínela y deje solo el documento XML. |
| Problemas de codificación (BOM, encoding declarado incorrecto) |
El archivo contiene un BOM, usa una codificación extraña o declara un encoding incorrecto que rompe el análisis.
|
Guarde el archivo como UTF‑8 (sin BOM) y confirme que la cabecera es correcta:
<?xml version="1.0" encoding="UTF-8"?>. Después pegue el XML a mano.
|
| El sitemap es demasiado grande (tamaño / límites del navegador) | El archivo es enorme (decenas de MB). El navegador puede quedarse sin memoria, bloquearse o no procesar toda la lista. | Divida el sitemap en archivos más pequeños (buena práctica: hasta 50.000 URL por archivo) y use un índice de sitemaps, o procéselo por partes. |
| Ha cargado un índice de sitemaps (no un sitemap de URL de páginas) | Solo contiene enlaces a otros sitemaps (sitemaps hijos), no URL de páginas: por eso puede no ver URL de páginas en el resultado. | Extraiga primero las URL de los sitemaps hijos y, a continuación, analice cada uno para obtener la lista final de URL de páginas. |
| Faltan etiquetas <loc> / estructura de sitemap no estándar |
El sitemap se genera de forma incorrecta (sin etiquetas <loc>) o es un XML personalizado que no sigue el protocolo de sitemaps.
|
Corrija la generación del sitemap en su CMS/plugin. En WordPress, revise el plugin SEO (Yoast/RankMath) o el nativo /wp-sitemap.xml.
|
| La CDN/caché devuelve contenido distinto (varía por geo/UA) | El servidor devuelve respuestas distintas según User‑Agent, país u otras reglas: XML para unas solicitudes, HTML o errores para otras. | Revise las reglas de CDN/WAF (variaciones UA/geo) y permita el acceso al sitemap sin comprobaciones estrictas de bots. Asegúrese de que siempre devuelva el mismo XML con estado 200. |
| Límite de peticiones (429 Too Many Requests) | El servidor limita la frecuencia de solicitudes y devuelve 429. Es habitual en hosting con pocos recursos o seguridad estricta. | Aumente los límites, añada caché y permita el acceso al sitemap. Si la obtención sigue fallando, use el pegado manual de XML como alternativa. |
¿Para quién es esta herramienta?
Un extractor de sitemaps XML ahorra horas de trabajo manual: obtiene una lista de URL limpia y la usa para SEO técnico, cobertura de índice, link building, auditorías de contenido y QA de migraciones, sin rastrear todo el sitio ni copiar y pegar URL.
Auditores de SEO técnico
Obtenga con rapidez una lista de URL del sitemap para una auditoría técnica: compruebe códigos HTTP (404/410/5xx), detecte redirecciones y cadenas 301/302, encuentre duplicados y problemas de canonical, y verifique si robots.txt o noindex bloquean la indexación. Esto afecta de forma directa al presupuesto de rastreo, a la frecuencia de rastreo y a la cobertura del índice.
Ejemplo: exporte las URL del sitemap y ejecute una comprobación masiva de estado/redirecciones para ver qué secciones fallan y dónde se desperdicia el rastreo, en 10-15 minutos.
QA de migraciones y rediseños
Cuando cambia de dominio, pasa de HTTP a HTTPS, cambia WWW frente a no WWW o reconstruye la estructura, necesita que cada URL antigua apunte a la URL nueva correcta mediante un 301, sin bucles ni cadenas largas. Una lista basada en el sitemap es la forma más rápida de validar la migración de extremo a extremo.
Ejemplo: extraiga las URL del sitemap del dominio antiguo y compárelas con la estructura nueva: qué páginas redirigen correctamente a equivalentes relevantes y cuáles caen en un 404 o en una cadena de redirección desordenada.
Equipos de contenido y editores
Ideal para inventario y auditoría de contenido: reúna todas las entradas y páginas en una hoja, agrúpelas en clústeres temáticos, detecte duplicados y canibalización de palabras clave, y planifique actualizaciones, enlazado interno y mejoras de metaetiquetas.
Ejemplo: exporte las URL del blog desde el sitemap y cree un seguimiento en Google Sheets: estado de índice, tráfico, fecha de última actualización, responsable y un plan de acción.
Link building y verificación de publicaciones
Si compra enlaces, publica guest posts o gestiona publicaciones de PR, necesita saber que las páginas donantes están indexadas en Google y no desaparecen de los SERP. Un extractor de sitemaps le ayuda a reunir con rapidez el conjunto de URL del sitio donante, valorar la calidad, auditar backlinks y entender dónde conserva equidad de enlaces real. También sirve para investigar a la competencia y encontrar sitios donantes de competidores.
Ejemplo: analice el sitemap de un sitio donante, localice las secciones «blog / noticias / artículos» y verifique que las páginas con sus publicaciones o backlinks estén indexadas (y no se hayan desindexado).
E-commerce y catálogos grandes
En sitios e-commerce, los sitemaps son una fuente rápida de URL de categoría y producto. Facilita revisar la cobertura de índice, encontrar problemas de parámetros, páginas de filtro (navegación facetada), paginación y duplicados que desperdician presupuesto de rastreo y ralentizan la indexación.
Ejemplo: exporte por separado las URL del sitemap de productos y del de categorías, y compare la cobertura de índice: qué está indexado frente a qué falta por duplicados, canonicals, parámetros o límites de presupuesto de rastreo.
PBN, dominios caducados e investigación de nichos
Al trabajar con dominios caducados, reconstrucciones o PBN, suele querer una lectura rápida de la estructura y de cualquier «índice residual». Si hay sitemap, la lista de URL es perfecta para un cribado rápido: qué páginas existen, cuáles son indexables y qué conviene reconstruir primero.
Ejemplo: antes de comprar o reconstruir un dominio, extraiga las URL del sitemap (si existe), compruebe cuáles están indexadas, revise la estructura y priorice las secciones a restaurar.
Preguntas frecuentes
¿Por qué la herramienta no obtiene mi sitemap?
Los fallos de obtención suelen deberse a cortafuegos del servidor (como Cloudflare o ModSecurity) que bloquean las solicitudes automáticas. Si ocurre, abra el sitemap en el navegador, copie el código fuente (Ctrl+U) y use a mano la pestaña «Pegar código XML».
¿Puedo extraer URL de un archivo de índice de sitemaps?
Sí. Si proporciona un índice de sitemaps (un archivo padre que enlaza a otros sitemaps), la herramienta extraerá las ubicaciones de los sitemaps hijos. Después deberá procesar cada sitemap hijo por separado para obtener las URL finales de las páginas.
¿Admite sitemaps de imágenes o de vídeo?
Sí. El analizador busca etiquetas de ubicación estándar. En sitemaps de imágenes extrae la URL de la página padre. Admite los espacios de nombres XML estándar de WordPress, Shopify y Magento.
¿Cuántas URL puedo extraer de una vez?
La herramienta se ejecuta en su navegador y gestiona con holgura archivos de hasta 10 MB (unas 50.000 URL). En archivos extremadamente grandes, recomendamos dividirlos o aumentar la memoria asignada al navegador.
¿El extractor conserva los atributos hreflang?
En la actualidad, esta herramienta extrae la etiqueta principal <loc> (ubicación) para comprobar la indexación. No analiza atributos <xhtml:link> de idiomas alternativos para mantener la salida limpia para herramientas de auditoría masiva.
¿Por qué es importante la fecha de última modificación?
Google usa la etiqueta <lastmod> para determinar si una página ha cambiado desde el último rastreo. Este extractor elimina los metadatos para ofrecer una lista de URL en bruto, el formato requerido por comprobadores masivos de índice y rastreadores.
¿Los datos extraídos son seguros?
Sí. El análisis ocurre en local en su navegador (en el cliente) o a través de un proxy sin estado. No almacenamos ni registramos los datos de su sitemap.
¿Cómo obtener la URL del sitemap?
Empiece por las dos comprobaciones más rápidas: (1) abra https://example.com/robots.txt y busque una línea Sitemap:, (2) pruebe rutas habituales como /sitemap.xml, /sitemap_index.xml o /wp-sitemap.xml (WordPress). Muchos CMS también enlazan el sitemap en los ajustes del plugin SEO.
¿Cómo obtener datos XML de un sitio web?
Abra la URL XML directamente en el navegador (por ejemplo, la URL de un sitemap). Si el sitio bloquea la obtención automática (403/WAF), use Ctrl+U (Ver código fuente) para copiar el XML en bruto y péguelo en la pestaña «Pegar código XML». Así evita problemas de CORS y muchas restricciones de obtención.
¿Los sitemaps siguen siendo relevantes en 2026?
Sí. Los sitemaps XML siguen siendo un archivo clave de SEO técnico para el descubrimiento y la priorización del rastreo, sobre todo en sitios grandes, catálogos e-commerce, medios y proyectos con actualizaciones frecuentes. No garantizan la indexación, pero ayudan a los motores a encontrar URL importantes, interpretar señales de actualización (<lastmod>) y reducir páginas omitidas en el rastreo.
¿Cómo obtener URL de un archivo XML?
En un sitemap estándar, las URL están dentro de la etiqueta <loc>. Esta herramienta extrae todos los valores <loc> y genera una lista limpia, una URL por línea, que puede copiar o exportar a TXT/CSV/PDF.
¿Cómo descargar el archivo sitemap.xml?
Abra la URL del sitemap en el navegador (por ejemplo https://example.com/sitemap.xml). Después, (1) clic derecho → «Guardar como…», o (2) abra DevTools → Red, recargue la página, pulse la solicitud del sitemap y guarde la respuesta. Si la descarga está bloqueada por el WAF, use Ctrl+U (Ver código fuente) y copie el XML en bruto.
¿Google tiene un generador de sitemaps?
Google no ofrece un botón universal de «generar sitemap» en Search Console. En la práctica, los sitemaps los genera su CMS (WordPress, Shopify, Magento, etc.), un plugin SEO (Yoast/RankMath) o su backend/framework. Una vez generado, envíe la URL del sitemap en Google Search Console.
¿Cómo descargar XML desde el navegador?
Si el XML se abre en el navegador, suele bastar con clic derecho y «Guardar como…». Si no funciona, use Ctrl+U (Ver código fuente) para copiar el XML en bruto, o use DevTools → Red para abrir la solicitud y copiar o guardar el cuerpo de la respuesta.
¿Cómo se usa un sitemap XML?
Flujo habitual: (1) genere el sitemap en su CMS/plugin SEO, (2) asegúrese de que devuelve 200 OK y contiene URL <loc> válidas, (3) envíelo en Google Search Console, (4) supervise la cobertura y los estados de indexación, y (5) exporte URL para auditorías masivas (comprobación de índice, códigos de respuesta, validación de redirecciones, QA de migración). Este extractor ayuda en el paso (5) al convertir el XML en una lista de URL limpia.